Há alguns dias, o canto inferior direito deste site ganhou um botão de chat. Ele responde perguntas sobre meus projetos, artigos, experiência e formas de contato, sempre com links para as páginas que usou. Eu queria um assistente útil, mas com regras claras: falar só do que está publicado aqui, não inventar nada sobre mim e não virar uma conta surpresa no fim do mês.
A ideia central: responder só com o que está publicado
Um modelo de linguagem sozinho não sabe nada sobre este portfólio e, quando não sabe, tende a completar com algo plausível. Para evitar isso, o assistente usa RAG (retrieval-augmented generation): antes de responder, ele busca os trechos do site mais parecidos com a pergunta e entrega esses trechos ao modelo, com a instrução de responder apenas com base neles.
A base de conhecimento é o próprio site: os artigos publicados, os projetos dos Labs, os jogos, o currículo e a página Sobre, nos três idiomas. Rascunhos nunca entram. Se a resposta não está nesse conteúdo, o assistente diz isso e aponta a página de contato.
Os componentes
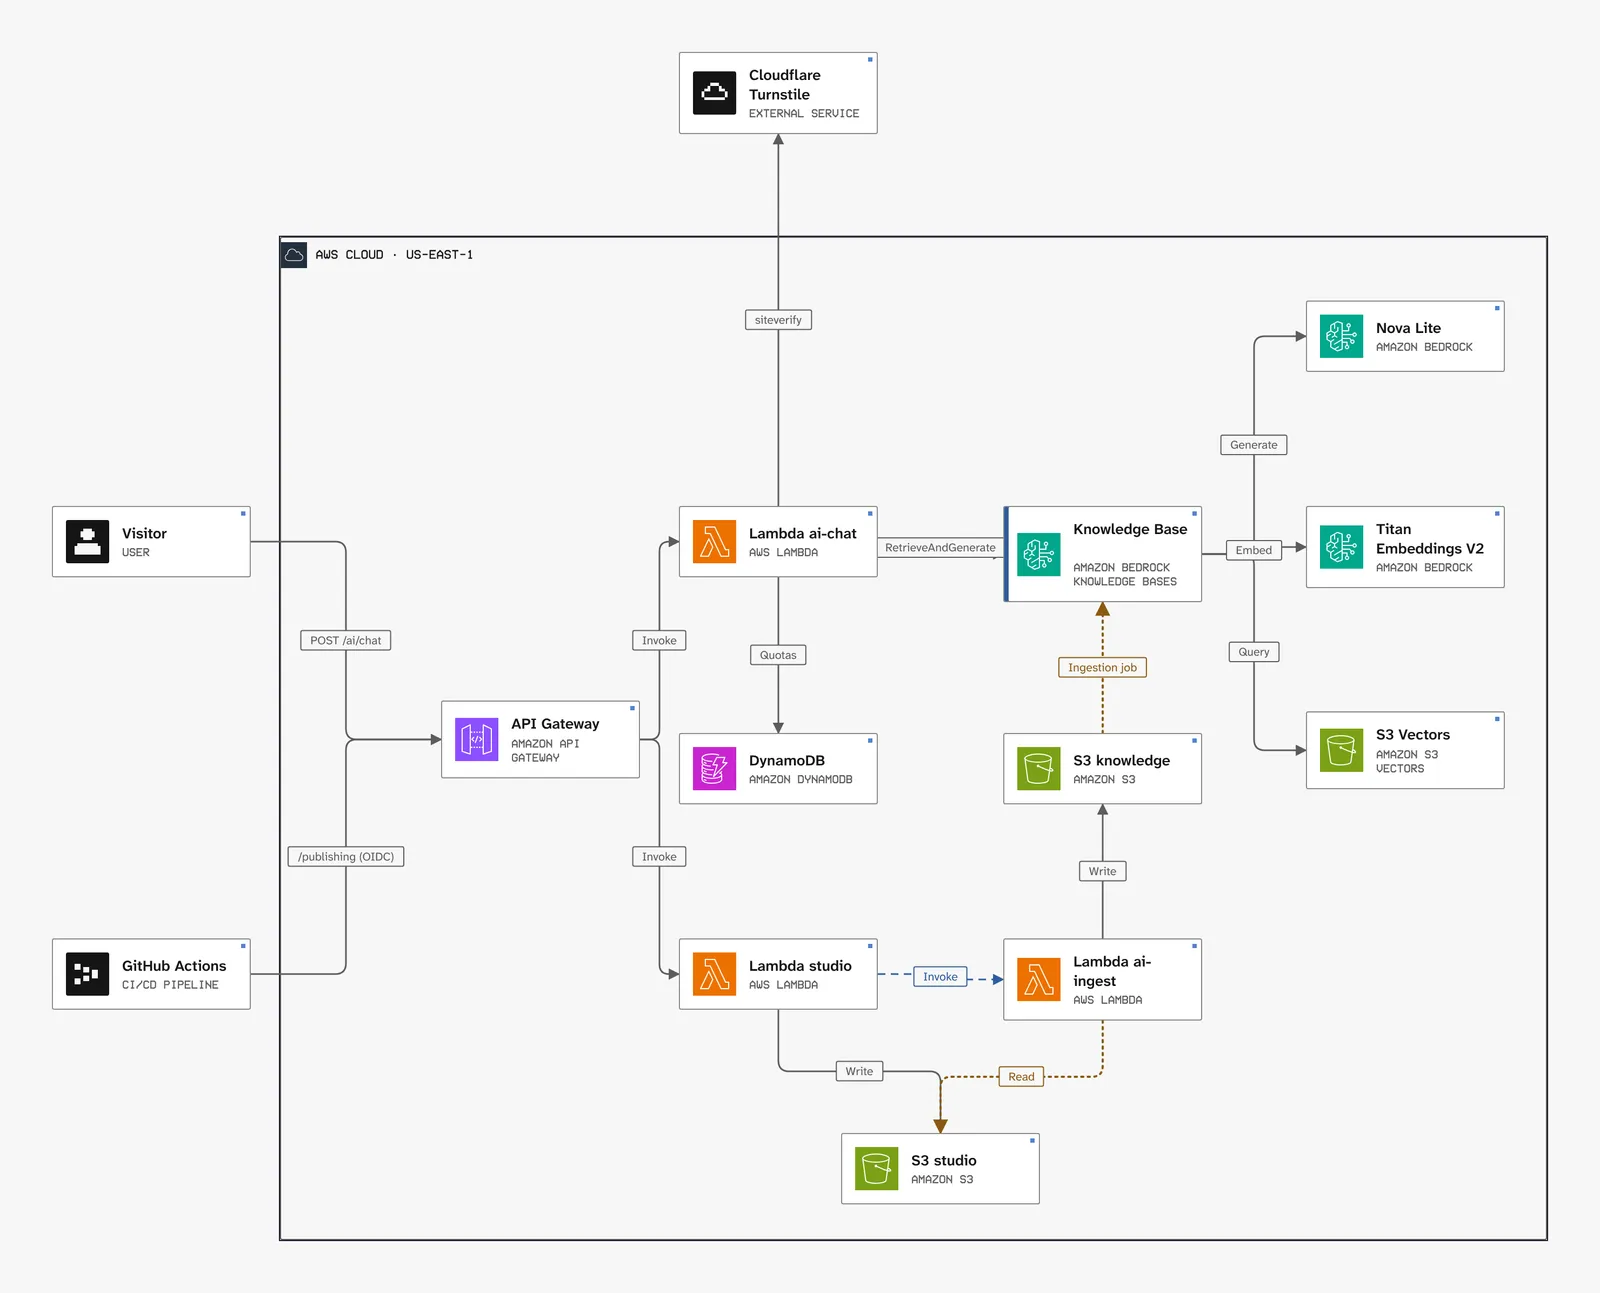
Tudo roda em us-east-1 e é cobrado por uso. Nada aqui tem custo fixo mensal.
API Gateway e Lambda: a mesma HTTP API do blog ganhou a rota
POST /ai/chat, atendida por uma Lambda própria, a única com permissão para chamar o modelo.Amazon Bedrock Knowledge Bases: faz o RAG de forma gerenciada. Com a API
RetrieveAndGenerate, uma única chamada busca os trechos e gera a resposta.Titan Text Embeddings V2: transforma cada trecho e cada pergunta num vetor de 1024 dimensões. O modelo é multilíngue, então uma pergunta em inglês encontra um texto em português.
Amazon S3 Vectors: guarda os vetores e os metadados e faz a busca por similaridade. Escolhi o S3 Vectors em vez do OpenSearch Serverless porque, para um site deste tamanho, ele custa centavos, e o OpenSearch teria um custo fixo.
Amazon Nova Lite: escreve a resposta. É barato, responde bem em português, inglês e espanhol e roda na própria região, sem inferência entre regiões.
DynamoDB: a mesma tabela do CMS guarda sessões, contadores de uso e os interruptores do assistente.
Como uma pergunta vira resposta
O navegador envia a pergunta e o idioma da página. Na primeira pergunta de cada conversa, envia também um token do Cloudflare Turnstile, e a Lambda confirma com a Cloudflare que há uma pessoa do outro lado.
A Lambda verifica se o assistente está ligado e quais documentos foram retirados do ar.
Numa única transação do DynamoDB, a pergunta é contada contra todos os limites: por conversa, por visitante e do assistente inteiro. Se algum estourar, a resposta é recusada ali mesmo, e o modelo nem é chamado.
A Lambda chama o Bedrock. Ele transforma a pergunta em vetor, busca os cinco trechos mais próximos no idioma da página e passa tudo ao Nova Lite.
A resposta volta com as citações, ou seja, os trechos que a sustentam. Os links mostrados abaixo da resposta saem dos metadados desses trechos, nunca do texto do modelo, e só podem apontar para páginas deste site.
Se nenhum trecho válido sustenta a resposta, o visitante recebe uma mensagem fixa dizendo que a informação não está no portfólio, com um link para a página Sobre.
Como o assistente aprende
O assistente não tem um processo próprio de publicação. Ele pega carona no deploy do site que descrevi no primeiro post.
O build do site, além das páginas, gera os textos de projetos, jogos, currículo e perfil a partir do mesmo conteúdo que as páginas usam. Esse arquivo fica fora do pacote publicado.
Antes de reportar o resultado, o workflow envia esses textos à API, provando quem é com o token OIDC do GitHub Actions.
Se o deploy der certo, a API aciona uma Lambda de ingestão. Ela monta um Markdown por página e idioma a partir do snapshot congelado no deploy, compara com o que já está indexado e grava só o que mudou, com um arquivo de metadados ao lado.
Um job de ingestão do Bedrock quebra os arquivos novos em trechos de 300 tokens, gera os vetores e atualiza o índice. Em cerca de um minuto, o assistente já conhece o artigo novo.
Se o deploy falhar, nada é indexado. Um detalhe de privacidade: o PDF do currículo não entra na base, porque tem dados que o site não mostra. O assistente lê a mesma versão do currículo que a página exibe.
Custo previsível
Um endpoint público que chama um modelo pago precisa de limites que não dependam de boa vontade. Estes são os do assistente:
Por conversa: até 10 perguntas, e a conversa dura uma hora.
Por visitante: 5 perguntas por minuto, 30 por dia e 6 conversas novas por dia. O visitante é identificado por um hash do endereço de rede, que expira em até dois dias.
Do assistente inteiro: 200 chamadas ao modelo por dia, 3.000 por mês e no máximo três ao mesmo tempo.
Os contadores ficam no DynamoDB e são incrementados numa única transação com condições, então pedidos simultâneos não conseguem passar do limite. Se o DynamoDB não responder, o pedido é recusado e o modelo não é chamado.
Na conta, cada pergunta custa no máximo uns US$ 0,0005, e o teto mensal fica em torno de US$ 1,40 de modelo. Um orçamento no AWS Budgets avisa por e-mail quando a conta passa de US$ 5, 8 e 10 no mês, mas ele só avisa: quem segura o gasto são as quotas.
Segurança
Sem ferramentas: o modelo só escreve texto. Ele não envia e-mail, não mexe no CMS e não acessa nada privado.
Conteúdo como dado: se algum texto tentar dar ordens ao modelo, o prompt deixa claro que os trechos são dados, não instruções. E mesmo que funcionasse, não haveria o que executar.
Sessões opacas: o navegador recebe só um token aleatório. A sessão do Bedrock fica no servidor, então ninguém continua a conversa de outra pessoa adivinhando um identificador.
Privacidade: perguntas e respostas não são gravadas nos logs, e o painel avisa que a pergunta vai para o Amazon Bedrock.
Interruptores: um comando suspende o chat na hora, e outro tira do ar um documento específico antes mesmo de o índice ser atualizado.
Desenvolver sem AWS
Como no CMS, dá para trabalhar no assistente sem conta na AWS. O npm run dev da API simula o Bedrock com uma busca por palavras sobre os mesmos documentos que a ingestão gera, e o Turnstile aceita o token de teste da Cloudflare. A resposta local avisa que é uma simulação, mas o resto do caminho é o de verdade: limites, sessões, citações e links.
O que aprendi no caminho
O S3 me pegou de novo com um 403. A Lambda de ingestão não tem permissão para listar o bucket do CMS, então um arquivo que não existe responde 403, e não 404. É a mesma lição do primeiro post, agora do lado do backend.
O
RetrieveAndGeneratenão informa quantos tokens usou. Por isso a quota mensal conta chamadas, cada uma com um custo máximo conhecido, e não tokens.O modelo mais novo nem sempre serve. O Nova 2 Lite só roda com inferência entre regiões, e a ficha técnica dele não lista Knowledge Bases. Vale ler o model card antes de escolher.
Remover um documento leva tempo. Os vetores de um artigo despublicado só somem quando o job de ingestão termina. Para fechar essa janela, a ingestão primeiro coloca o documento numa lista de revogados, que toda busca exclui, e só depois apaga os arquivos.
O assistente está no canto da tela. Pergunte o que quiser sobre o portfólio, e me conte se ele errar. Obrigado por ler até aqui.