Hace unos días, la esquina inferior derecha de este sitio ganó un botón de chat. Responde preguntas sobre mis proyectos, artículos, experiencia y formas de contacto, siempre con enlaces a las páginas que usó. Quería un asistente útil, pero con reglas claras: hablar solo de lo que está publicado aquí, no inventar nada sobre mí y no convertirse en una factura sorpresa a fin de mes.
La idea central: responder solo con lo que está publicado
Por sí solo, un modelo de lenguaje no sabe nada sobre este portafolio y, cuando no sabe, tiende a completar con algo plausible. Para evitarlo, el asistente usa RAG (retrieval-augmented generation): antes de responder, busca los fragmentos del sitio más parecidos a la pregunta y se los entrega al modelo, con la instrucción de responder solo a partir de ellos.
La base de conocimiento es el propio sitio: los artículos publicados, los proyectos de Labs, los juegos, el currículum y la página Sobre mí, en los tres idiomas. Los borradores nunca entran. Si la respuesta no está en ese contenido, el asistente lo dice y señala la página de contacto.
Las piezas
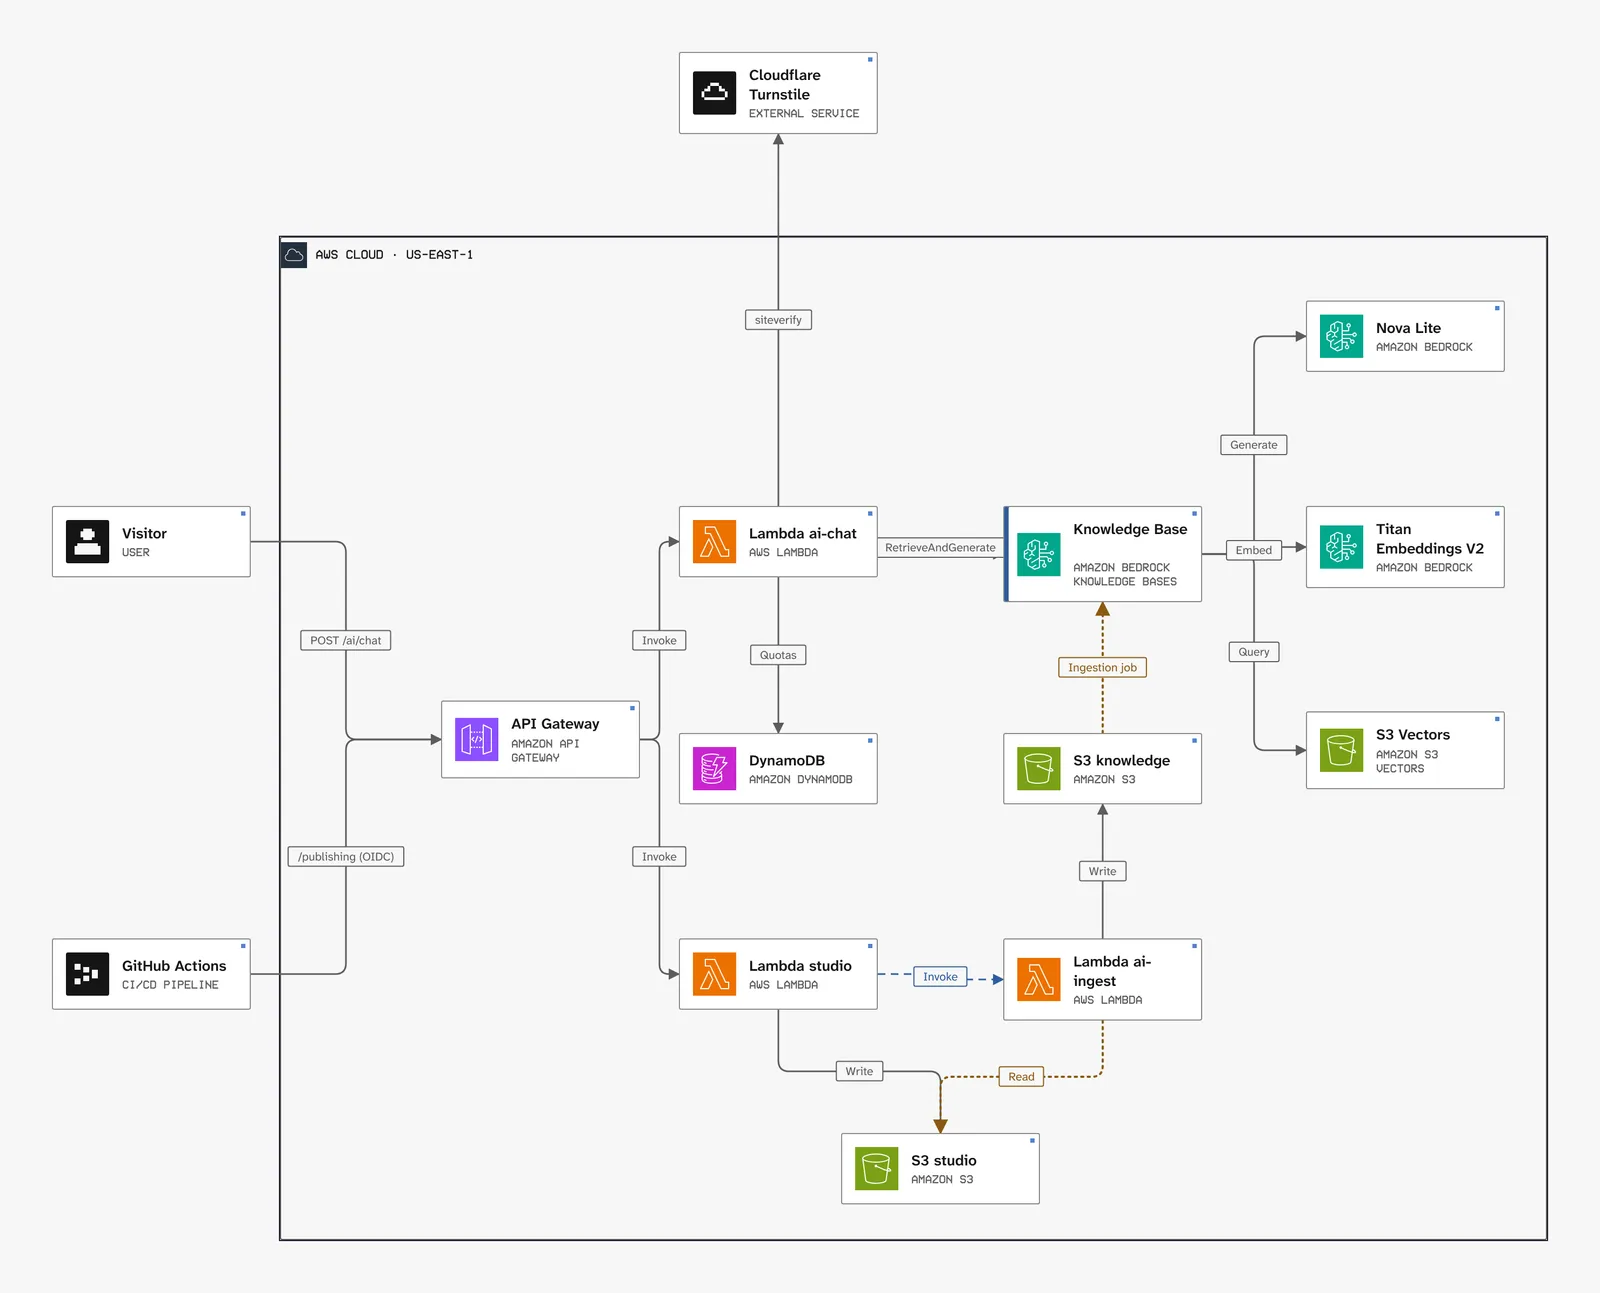
Todo corre en us-east-1 y se cobra por uso. Nada aquí tiene un costo fijo mensual.
API Gateway y Lambda: la misma HTTP API del blog ganó la ruta
POST /ai/chat, atendida por una Lambda propia, la única con permiso para llamar al modelo.Amazon Bedrock Knowledge Bases: hace el RAG como servicio administrado. Con la API
RetrieveAndGenerate, una sola llamada busca los fragmentos y genera la respuesta.Titan Text Embeddings V2: convierte cada fragmento y cada pregunta en un vector de 1024 dimensiones. El modelo es multilingüe, así que una pregunta en inglés encuentra un texto en portugués.
Amazon S3 Vectors: guarda los vectores y sus metadatos y hace la búsqueda por similitud. Elegí S3 Vectors en lugar de OpenSearch Serverless porque, para un sitio de este tamaño, cuesta centavos, mientras que OpenSearch tendría un costo fijo.
Amazon Nova Lite: escribe la respuesta. Es barato, responde bien en portugués, inglés y español y corre en la misma región, sin inferencia entre regiones.
DynamoDB: la misma tabla del CMS guarda sesiones, contadores de uso y los interruptores del asistente.
Cómo una pregunta se convierte en respuesta
El navegador envía la pregunta y el idioma de la página. En la primera pregunta de cada conversación también envía un token de Cloudflare Turnstile, y la Lambda confirma con Cloudflare que hay una persona del otro lado.
La Lambda verifica que el asistente esté encendido y qué documentos se retiraron.
En una sola transacción de DynamoDB, la pregunta se cuenta contra todos los límites: por conversación, por visitante y del asistente completo. Si alguno se supera, la solicitud se rechaza ahí mismo, y el modelo ni siquiera se llama.
La Lambda llama a Bedrock. Convierte la pregunta en vector, busca los cinco fragmentos más cercanos en el idioma de la página y se los pasa a Nova Lite.
La respuesta vuelve con sus citas, es decir, los fragmentos que la respaldan. Los enlaces bajo la respuesta salen de los metadatos de esos fragmentos, nunca del texto del modelo, y solo pueden apuntar a páginas de este sitio.
Si ningún fragmento válido respalda la respuesta, el visitante recibe un mensaje fijo que dice que la información no está en el portafolio, con un enlace a la página Sobre mí.
Cómo aprende el asistente
El asistente no tiene un proceso de publicación propio. Se apoya en el despliegue del sitio que describí en el primer post.
Además de las páginas, el build del sitio genera los textos de proyectos, juegos, currículum y perfil a partir del mismo contenido que usan las páginas. Ese archivo queda fuera del paquete publicado.
Antes de reportar el resultado, el workflow envía esos textos a la API y demuestra quién es con el token OIDC de GitHub Actions.
Si el despliegue sale bien, la API activa una Lambda de ingesta. Arma un Markdown por página e idioma a partir del snapshot congelado en el despliegue, lo compara con lo que ya está indexado y guarda solo lo que cambió, con un archivo de metadatos al lado.
Un job de ingesta de Bedrock divide los archivos nuevos en fragmentos de 300 tokens, genera los vectores y actualiza el índice. En alrededor de un minuto, el asistente ya conoce el artículo nuevo.
Si el despliegue falla, no se indexa nada. Un detalle de privacidad: el PDF del currículum no entra en la base, porque tiene datos que el sitio no muestra. El asistente lee la misma versión del currículum que muestra la página.
Costo previsible
Un endpoint público que llama a un modelo pago necesita límites que no dependan de la buena voluntad. Estos son los del asistente:
Por conversación: hasta 10 preguntas, y la conversación dura una hora.
Por visitante: 5 preguntas por minuto, 30 por día y 6 conversaciones nuevas por día. El visitante se identifica por un hash de su dirección de red, que expira en hasta dos días.
Del asistente completo: 200 llamadas al modelo por día, 3000 por mes y como máximo tres al mismo tiempo.
Los contadores están en DynamoDB y se incrementan en una sola transacción con condiciones, así que las solicitudes simultáneas no pueden pasar del límite. Si DynamoDB no responde, la solicitud se rechaza y el modelo no se llama.
En números, cada pregunta cuesta como máximo unos US$ 0,0005, y el techo mensual ronda los US$ 1,40 de modelo. Un presupuesto en AWS Budgets me avisa por correo cuando la cuenta pasa de US$ 5, 8 y 10 en el mes, pero solo avisa: lo que contiene el gasto son las cuotas.
Seguridad
Sin herramientas: el modelo solo escribe texto. No envía correos, no toca el CMS y no accede a nada privado.
Contenido como dato: si algún texto intenta dar órdenes al modelo, el prompt deja claro que los fragmentos son datos, no instrucciones. Y aunque funcionara, no habría nada que ejecutar.
Sesiones opacas: el navegador recibe solo un token aleatorio. La sesión de Bedrock queda en el servidor, así que nadie continúa la conversación de otra persona adivinando un identificador.
Privacidad: las preguntas y respuestas no se guardan en los logs, y el panel avisa que la pregunta va a Amazon Bedrock.
Interruptores: un comando suspende el chat al instante, y otro retira un documento específico incluso antes de que se actualice el índice.
Desarrollar sin AWS
Como en el CMS, puedo trabajar en el asistente sin una cuenta de AWS. El npm run dev de la API simula Bedrock con una búsqueda por palabras sobre los mismos documentos que genera la ingesta, y Turnstile acepta el token de prueba de Cloudflare. La respuesta local avisa que es una simulación, pero el resto del camino es el real: límites, sesiones, citas y enlaces.
Lo que aprendí en el camino
S3 me atrapó otra vez con un 403. La Lambda de ingesta no tiene permiso para listar el bucket del CMS, así que un archivo que no existe responde 403, no 404. La misma lección del primer post, ahora del lado del backend.
RetrieveAndGenerateno informa cuántos tokens usó. Por eso la cuota mensual cuenta llamadas, cada una con un costo máximo conocido, y no tokens.El modelo más nuevo no siempre sirve. Nova 2 Lite solo corre con inferencia entre regiones, y su ficha técnica no incluye Knowledge Bases. Vale la pena leer el model card antes de elegir.
Retirar un documento lleva tiempo. Los vectores de un artículo despublicado solo desaparecen cuando termina el job de ingesta. Para cerrar esa ventana, la ingesta primero pone el documento en una lista de revocados, que toda búsqueda excluye, y solo después borra los archivos.
El asistente está en la esquina de la pantalla. Pregúntale lo que quieras sobre el portafolio, y cuéntame si se equivoca. Gracias por leer hasta aquí.